

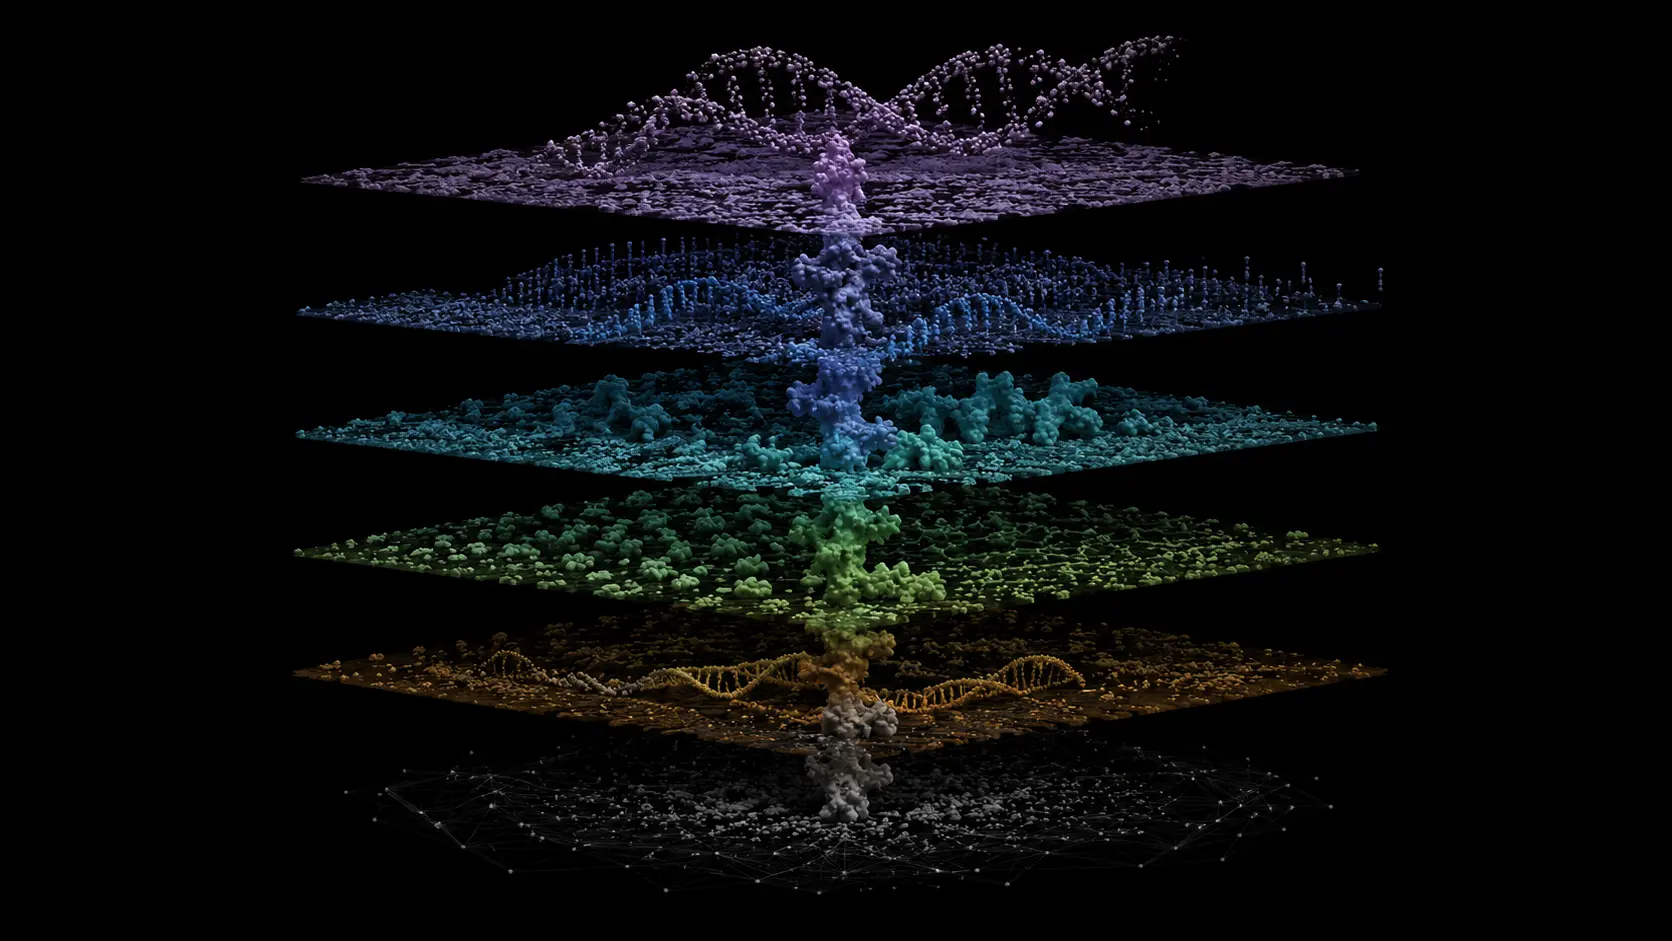
Multiomics, biyolojik sistemleri farklı katmanlarda eş zamanlı olarak inceleyen bir yaklaşım olarak öne çıkıyor. Genomik, transkriptomik, proteomik ve metabolomik gibi omik katmanlarından elde edilen devasa veri setleri, tek başlarına sınırlı bir bakış açısı sunar. Ancak bu katmanlar birleştirildiğinde, hücresel süreçlerin bütünsel bir resmi ortaya çıkar.
Örneğin, bir genin ekspresyon seviyesindeki değişim, protein miktarını veya metabolik ürünleri doğrudan yansıtmayabilir. Bu nedenle, multiomics stratejiler, biyolojik karmaşıklığı anlamak için vazgeçilmez hale gelmiştir.
Geliştiriciler ve teknik ekipler için multiomics, yalnızca veri analizi değil, aynı zamanda veri yönetimi, istatistiksel modelleme ve makine öğrenmesi gibi disiplinleri de içeren çok yönlü bir zorluk sunar. Her omik katmanın kendine özgü veri formatları, gürültü seviyeleri ve biyolojik varyasyon kaynakları vardır.
Bu çeşitlilik, entegrasyon sürecinde ciddi teknik engeller oluşturur. Örneğin, bir RNA dizileme deneyinden elde edilen sayım verileri ile bir kütle spektrometresi çıktısı arasında doğrudan bir karşılaştırma yapmak mümkün değildir. Bu yüzden, veri ön işleme adımları her katman için ayrı ayrı optimize edilmelidir.
Bu yazıda, multiomics projelerine yeni başlayanların karşılaştığı temel kavramları ve zorlukları ele alacağız. Özellikle veri entegrasyonunun metodolojik yönlerine, istatistiksel yaklaşımlara ve biyolojik yorumlamaya odaklanacağız. Amacımız, okuyucunun bu alanda sağlam bir kavramsal çerçeve edinmesini sağlamak ve pratikte karşılaşabileceği sorunlara hazırlıklı olmasına yardımcı olmaktır.
1. Veri Türleri ve Ön İşleme Zorlukları
Multiomics veri entegrasyonunun ilk adımı, farklı omik katmanlarından gelen verileri anlamak ve uygun şekilde ön işlemekten geçer. Her veri türü kendine özgü bir yapıya sahiptir. Genomik veriler, varyant çağrıları ve kopya sayısı değişikliklerini içerir. Transkriptomik veriler genellikle gen ekspresyon matrisleri olarak temsil edilir. Proteomik ve metabolomik veriler ise yoğunluk ölçümleri veya kütle spektrumları şeklinde olabilir. Bu çeşitlilik, veri formatlarının standardizasyonunu zorlaştırır ve entegrasyon öncesinde dikkatli bir dönüşüm gerektirir.
Ön işleme adımları, her omik katman için farklılık gösterir. Örneğin, RNA dizileme verilerinde normalizasyon yöntemleri (örneğin, TPM veya FPKM) kritik öneme sahiptir. Proteomik verilerde ise log dönüşümü ve merkezileştirme sıkça uygulanır. Metabolomik verilerde ise pik hizalama ve bileşik tanımlama gibi adımlar eklenir. Bu farklılıklar, entegrasyon sırasında biyolojik sinyallerin korunması ve teknik varyasyonun giderilmesi için iyi bir ön işleme stratejisi gerektirir.
Ayrıca, veri kalitesi ve eksik veri sorunları multiomics projelerinde sıkça karşılaşılan bir durumdur. Farklı omik katmanlarda ölçüm eksiklikleri olabilir. Örneğin, bir genin transkripti tespit edilirken proteini tespit edilemeyebilir. Bu tür eksiklikler, entegrasyon algoritmalarının performansını etkileyebilir. Bu nedenle, eksik veri yönetimi ve imputasyon yöntemleri, multiomics analizlerinde önemli bir yer tutar.
Multiomics veri entegrasyonunda en büyük zorluk, farklı omik katmanlarındaki teknik varyasyonun biyolojik sinyali maskelemesidir.
2. Entegrasyon Yöntemleri ve Stratejileri
Multiomics veri entegrasyonu için çeşitli istatistiksel ve hesaplamalı yöntemler geliştirilmiştir. Bu yöntemler, veri matrislerini birleştirme veya ortak bir temsil alanına projekte etme yaklaşımlarına dayanır. İlk olarak, konkatenasyon tabanlı yöntemler, tüm omik katmanlardan gelen verileri tek bir matriste birleştirir. Bu yaklaşım basit ve anlaşılırdır, ancak yüksek boyutluluk ve ölçek farklılıkları nedeniyle sorunlara yol açabilir.
İkinci olarak, çok bloklu veri analizi yöntemleri, her omik katmanı ayrı bir blok olarak ele alır ve bu bloklar arasındaki kovaryans yapısını modeller. Örneğin, kısmi en küçük kareler regresyonu veya kanonik korelasyon analizi gibi yöntemler, iki veya daha fazla veri seti arasındaki ilişkileri ortaya çıkarır. Bu yöntemler, değişkenler arasındaki doğrusal ilişkileri yakalayabilir, ancak doğrusal olmayan etkileşimleri göz ardı edebilir.
Üçüncü olarak, faktöriyel analiz ve matris ayrıştırma yöntemleri, veri boyutunu azaltarak ortak faktörler veya bileşenler çıkarır. Örneğin, çoklu faktör analizi, her omik katmanın varyansını ayrı ayrı değerlendirir ve ardından ortak bir faktör yapısı oluşturur. Bu yaklaşım, gürültüyü azaltır ve görselleştirmeyi kolaylaştırır. Ayrıca, derin öğrenme tabanlı yöntemler, doğrusal olmayan ilişkileri modelleme kapasitesiyle öne çıkar. Otomatik kodlayıcılar ve varyasyonel otomatik kodlayıcılar, farklı omik katmanlarını birleştiren düşük boyutlu temsiller öğrenmek için kullanılır.
Bu yöntemlerin seçimi, araştırma sorusuna ve veri yapısına bağlıdır. Örneğin, sınıflandırma veya biyobelirteç keşfi için denetimli yöntemler tercih edilirken, keşifsel analiz için denetimsiz yöntemler daha uygundur. Ayrıca, entegrasyon sonrası biyolojik yorumlama için, modellerin yorumlanabilirliği önemli bir faktördür.
3. İstatistiksel Yaklaşımlar ve Makine Öğrenmesi
Multiomics veri analizinde, istatistiksel testler ve makine öğrenmesi algoritmaları sıklıkla kullanılır. Farklı omik katmanlarda farklı istatistiksel dağılımlar gözlemlenir. Örneğin, RNA dizileme verileri genellikle negatif binom dağılımına uyarken, proteomik veriler log-normal dağılıma daha yakındır. Bu nedenle, her katman için uygun istatistiksel modellerin seçilmesi gerekir.
Makine öğrenmesi yöntemleri, **özellikle yüksek boyutlu verilerde örüntü tanıma **ve tahmin için güçlü araçlar sunar. Rastgele orman, destek vektör makineleri ve gradyan artırma gibi yöntemler, multiomics verilerde sınıflandırma ve regresyon problemlerinde yaygın olarak kullanılır. Ancak, bu yöntemlerin aşırı öğrenme riskine karşı dikkatli olunmalıdır. Çapraz doğrulama ve düzenlileştirme teknikleri, model performansını artırmak için kritik öneme sahiptir.
Ayrıca, derin öğrenme modelleri, çok katmanlı veri entegrasyonu için umut verici sonuçlar göstermektedir. Örneğin, grafik sinir ağları, biyolojik ağlardaki ilişkileri modellemek için kullanılabilir. Bu modeller, gen düzenleyici ağlar veya protein-protein etkileşim ağları gibi yapısal bilgileri entegre ederek daha gerçekçi biyolojik modeller oluşturabilir. Bununla birlikte, bu modellerin eğitimi büyük veri ve hesaplama kaynakları gerektirir.
Multiomics analizlerinde makine öğrenmesi modelleri, tek omik verilere kıyasla daha yüksek doğruluk sağlayabilir, ancak yorumlanabilirlik her zaman ön planda tutulmalıdır.
4. Biyolojik Yorumlama ve Ağ Tabanlı Yaklaşımlar
Multiomics verilerin entegrasyonu, sadece istatistiksel modellerle sınırlı kalmaz. Elde edilen sonuçların biyolojik olarak anlamlı bir şekilde yorumlanması gerekir. Bu aşamada, yolak analizi, gen ontolojisi ve ağ tabanlı yöntemler öne çıkar. Örneğin, farklı omik katmanlarda anlamlı bulunan genlerin ortak biyolojik yollarda toplanıp toplanmadığı araştırılır. Bu tür analizler, karmaşık veri setlerini anlamlı biyolojik mekanizmalara bağlamak için önemlidir.
Ağ tabanlı yaklaşımlar, genlerin, proteinlerin ve metabolitlerin etkileşimlerini bir ağ olarak modeller. Örneğin, bir hastalıkla ilişkili genlerin **protein-protein etkileşim ağında **birbirine yakın olup olmadığı incelenebilir. Bu tür analizler, fonksiyonel ilişkileri ortaya çıkarmak ve önceliklendirilmiş hedefler belirlemek için kullanılır. Ayrıca, topluluk tespiti algoritmaları, ağda yoğun bağlantılı alt grupları belirleyerek biyolojik modüllerin keşfedilmesine yardımcı olur.
Biyolojik yorumlama sürecinde, veri entegrasyonundan elde edilen sonuçların doğrulanması da kritik bir adımdır. Bağımsız veri setleri veya deneysel doğrulamalar, bulguların güvenilirliğini artırır. Örneğin, transkriptomik ve proteomik verilerin entegrasyonu sonucu bulunan bir biyobelirteç, bağımsız bir kohortta doğrulanabilir. Bu tür doğrulamalar, multiomics analizlerinin klinik uygulamalara taşınmasında önemli bir rol oynar.
5. Araçlar ve Altyapı Gereksinimleri
Multiomics veri analizi, güçlü hesaplama kaynakları ve özel yazılım araçları gerektirir. Yüksek boyutlu veri setleri, bellek ve işlemci yoğun işlemler gerektirir. Bu nedenle, bulut tabanlı altyapılar ve yüksek performanslı hesaplama kümeleri sıklıkla kullanılır. Ayrıca, veri yönetimi için standart formatlar ve ontolojiler önemlidir. Örneğin, gen ifadesi verileri için ortak bir format kullanmak, farklı veri setlerinin entegrasyonunu kolaylaştırır.
Yazılım araçları arasında, istatistiksel programlama dilleri ve görselleştirme kütüphaneleri öne çıkar. R ve Python, multiomics analizleri için en yaygın kullanılan dillerdir. Biyoconductor gibi paketler, omik veri analizi için zengin bir ekosistem sunar. Ayrıca, entegrasyon algoritmalarını uygulayan özel paketler de mevcuttur. Bu araçlar, araştırmacıların verileri keşfetmesini ve analiz etmesini kolaylaştırır.
Ancak, bu araçların kullanımı belirli bir teknik beceri gerektirir. Geliştiricilerin ve teknik ekiplerin, veri manipülasyonu, istatistiksel modelleme ve makine öğrenmesi konularında yetkin olması beklenir. Ayrıca, veri güvenliği ve etik kurallar, özellikle insan verileriyle çalışırken dikkate alınmalıdır. Bu nedenle, multiomics projeleri, multidisipliner bir ekip yaklaşımı gerektirir.
Yeni Başlayanlar İçin Öneriler
Multiomics alanına yeni başlayanlar için bazı temel öneriler şunlardır:
- Öncelikle, her bir omik katmanın temel analiz yöntemlerini ayrı ayrı öğrenin. Bu, veri ön işleme ve kalite kontrol adımlarını anlamanızı sağlar.
- İkinci olarak, istatistiksel ve makine öğrenmesi yöntemlerine hakim olun. Özellikle, veri entegrasyonu için kullanılan algoritmaların matematiksel temellerini kavramak önemlidir.
- Üçüncü olarak, biyolojik bilgi birikiminizi geliştirin. Multiomics verileri yorumlamak için biyoloji alanında sağlam bir temel gereklidir.
- Dördüncü olarak, açık veri setleri ve topluluk kaynaklarından yararlanın. Örneğin, kanser genomik veri tabanları veya tek hücreli omik veri setleri, pratik deneyim kazanmak için idealdir.
- Son olarak, disiplinlerarası iş birliğine açık olun. Multiomics projeleri, biyologlar, bilgisayar bilimciler ve istatistikçilerin birlikte çalışmasını gerektirir.
Ayrıca, aşağıdaki noktalara dikkat etmek faydalı olacaktır:
- Veri kalitesi her şeyden önce gelir. Kötü ön işleme, yanıltıcı sonuçlara yol açabilir.
- Entegrasyon yöntemini seçerken, veri yapısını ve araştırma sorusunu göz önünde bulundurun.
- Sonuçları her zaman biyolojik bağlamda doğrulayın.
- Hesaplama kaynaklarınızı verimli kullanın ve gerektiğinde bulut çözümlerini tercih edin.
- Güncel literatürü takip edin ve yeni yöntemleri öğrenmeye açık olun.
Unutmayın: Multiomics veri entegrasyonu, tek bir omik katmanın analizinden çok daha karmaşıktır, ancak biyolojik sistemleri anlamak için eşsiz bir fırsat sunar.
Geleceğe Bakış ve Zorluklar
Multiomics alanı hızla gelişmeye devam ediyor. Veri entegrasyonunun standardizasyonu, farklı omik katmanlarının birlikte analiz edilmesi ve biyolojik sonuçların daha doğru yorumlanması, bugün hâlâ üzerinde çalışılan önemli konular arasında yer alıyor. Özellikle tek hücreli multiomics teknolojileri, hücresel heterojeniteyi anlamak için yeni fırsatlar sunarken, bu verilerin analizi daha gelişmiş yöntemler ve güçlü hesaplama altyapıları gerektiriyor.
Bir diğer önemli başlık ise veri paylaşımı ve etik süreçlerdir. Multiomics verileri çoğu zaman hassas genetik bilgiler içerdiği için güvenli veri yönetimi, gizlilik ilkeleri ve düzenleyici gereklilikler araştırmaların ayrılmaz bir parçası hâline geliyor. Üstelik laboratuvarda elde edilen bulguların klinik uygulamalara taşınabilmesi için kapsamlı doğrulama süreçleri ve klinik çalışmalar da büyük önem taşıyor.
Bu zorluklar ilk bakışta karmaşık görünse de doğru öğrenme planıyla yönetilebilir. Multiomics alanında ilerlemek, biyolojik kavramları, biyoinformatik araçlarını ve veri analizi becerilerini birlikte geliştirmeyi gerektirir.
Stepwise Plus olarak, multiomics öğrenme yolculuğunu daha anlaşılır ve uygulamalı hâle getirmeyi amaçlıyoruz. Gerçek veri setleriyle çalışabileceğiniz, modern biyoinformatik araçlarını adım adım öğrenebileceğiniz içerikler hazırlıyoruz. Multiomics'e yeni başlıyorsanız veya bu alandaki becerilerinizi geliştirmek istiyorsanız, bize ulaşabilir ve sizin için en uygun öğrenme yolunu birlikte planlayabiliriz.